RAG ed embedding: come far rispondere l'AI sui tuoi documenti
Come funziona la ricerca "per significato", cosa sono embedding e database vettoriali, come si costruisce un assistente che risponde sui documenti aziendali citando le fonti, e gli errori che lo rendono inaffidabile.
 Mattia PanattaPubblicato il 24 settembre 202613 minAvanzato
In breve
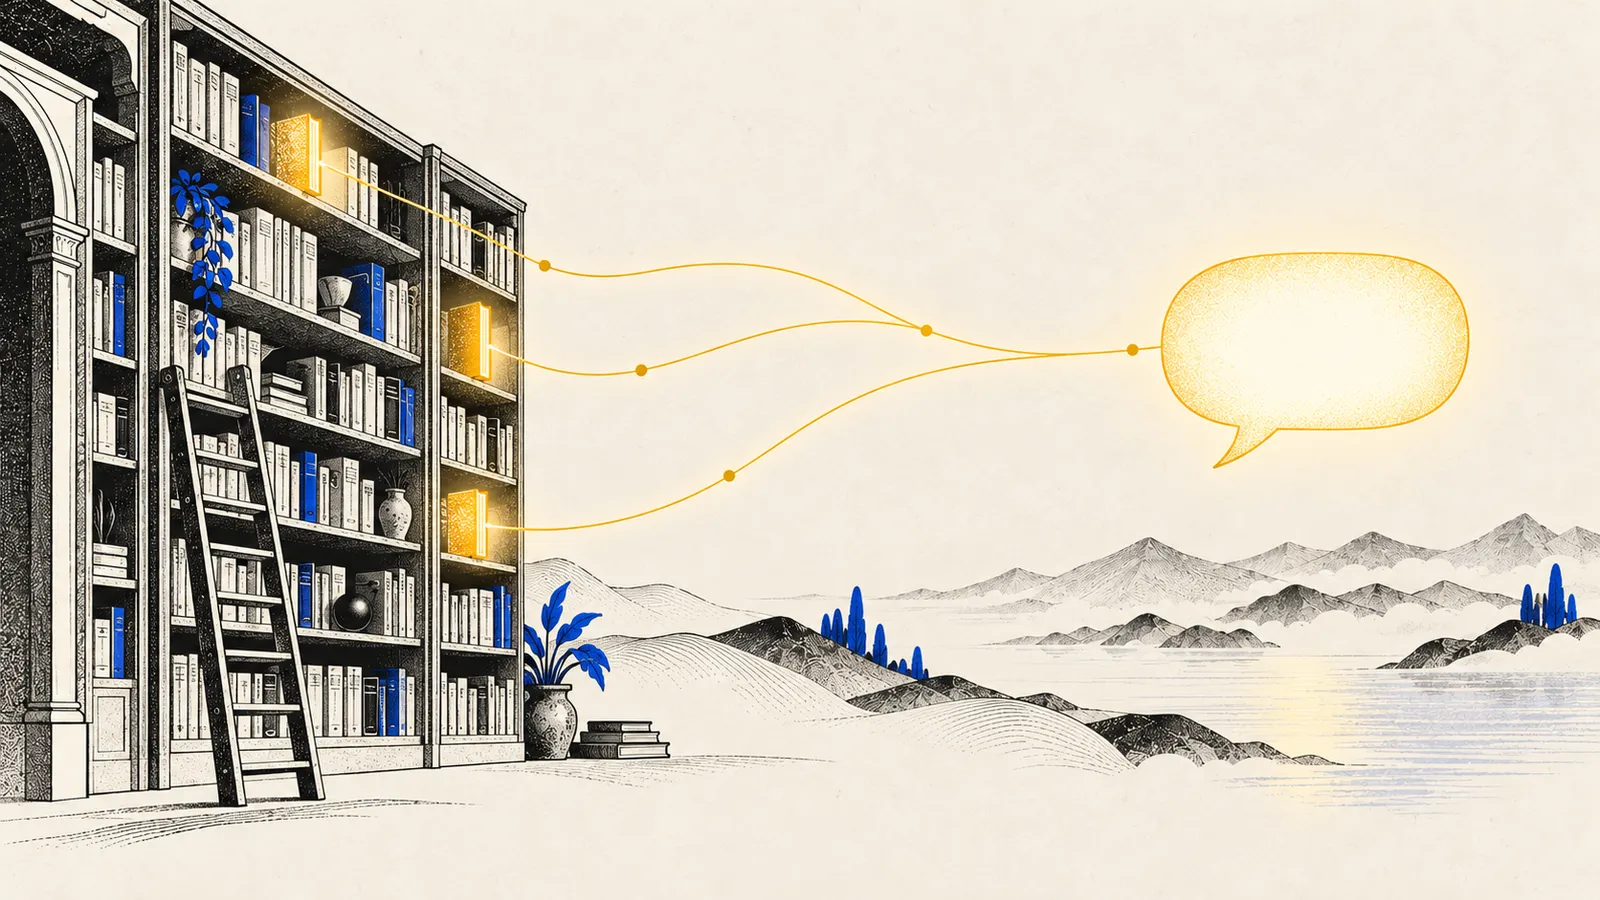
- RAG (Retrieval-Augmented Generation) significa: prima cerca i passaggi giusti nei documenti, poi fai rispondere il modello solo su quelli.
- La ricerca “per significato” usa gli embedding: ogni testo diventa un punto in uno spazio dove testi simili stanno vicini.
- La qualità dipende soprattutto da come dividi e prepari i documenti, non dal modello.
- Un buon sistema RAG cita le fonti e sa dire “non l’ho trovato”. Se non lo fa, non è affidabile.
Il problema che risolve
Un modello come GPT-6.1 Sol sa moltissimo del mondo, ma non sa nulla di te: il manuale interno, i contratti con i fornitori, le procedure dello studio, le circolari degli ultimi cinque anni. E anche se le sapesse, il suo sapere si ferma alla data di addestramento.
Si potrebbe incollare tutto nel contesto, visto che oggi le finestre arrivano a un milione di token? Per pochi documenti sì. Ma con migliaia di pagine costa troppo, è lento e, come abbiamo visto nella guida su contesto e memoria, le informazioni in mezzo vengono considerate meno. La soluzione è dare al modello solo i passaggi che servono, ogni volta.
Come funziona, passo per passo
1. Preparare i documenti
I documenti vengono convertiti in testo (anche PDF scansionati, con l’OCR) e divisi in pezzi (chunk) di qualche centinaio di parole, possibilmente rispettando la struttura: un articolo di un contratto, una sezione di un manuale, una domanda delle FAQ.
2. Calcolare gli embedding
Ogni pezzo viene trasformato da un modello apposito in un embedding: una lista di centinaia o migliaia di numeri che ne rappresenta il significato. Testi che parlano della stessa cosa, anche con parole diverse (“recesso anticipato” e “disdetta prima della scadenza”), finiscono vicini.
3. Salvare nell’indice
Gli embedding vanno in un database vettoriale (o in un normale database con funzioni vettoriali), che sa trovare in millisecondi i punti più vicini a un altro punto.
4. Cercare
Quando arriva una domanda, anche lei diventa un embedding. Il sistema prende i pezzi più vicini, spesso combinando la ricerca per significato con quella classica per parole chiave: la prima capisce i sinonimi, la seconda non si perde sigle, codici e numeri di articolo (la ricerca ibrida). Un passaggio di reranking può poi riordinare i risultati per pertinenza.
5. Rispondere citando
I pezzi trovati vengono inseriti nel contesto insieme alla domanda e a istruzioni precise: rispondi solo su questi testi, cita da dove prendi ogni affermazione, se non trovi la risposta dillo.
Lo vedi in azione su questo sito
Il chatbot di questo sito funziona così: le pagine del sito sono divise in sezioni e indicizzate; quando fai una domanda, il modello chiama uno strumento di ricerca, legge i passaggi trovati e risponde con i link alle sezioni esatte. Per le notizie fresche fa una seconda ricerca, sul web, limitata a quattro siti affidabili.
Gli errori che rendono un RAG inaffidabile
- Pezzi tagliati male. Se un articolo di contratto viene spezzato a metà, la risposta perde l’eccezione che stava nella seconda metà. Taglia seguendo la struttura e lascia una piccola sovrapposizione tra pezzi.
- Documenti vecchi e nuovi mescolati. Tre versioni della stessa procedura nell’indice producono risposte contraddittorie. Prima di indicizzare, fai pulizia e indica date e versioni.
- Solo ricerca semantica. Gli embedding faticano con codici, sigle e numeri (“art. 2426”, “modello F24”). La ricerca ibrida risolve gran parte del problema.
- Nessun “non lo so”. Se il sistema risponde sempre, risponderà anche quando non ha trovato nulla, inventando. Le istruzioni devono prevedere la risposta “non presente nei documenti”.
- Nessuna valutazione. Prepara 30-50 domande reali con la risposta giusta e misura quante volte il sistema trova il documento corretto. È l’unico modo per sapere se le modifiche migliorano o peggiorano.
- Permessi ignorati. Un assistente aziendale non deve mostrare a tutti i documenti delle risorse umane. Il controllo degli accessi va applicato prima della ricerca.
Costruirlo o comprarlo?
| Esigenza | Soluzione |
|---|---|
| Studiare o lavorare su pochi documenti, da soli | Gemini Notebook, Progetti di ChatGPT e Claude |
| Assistente per un team, documenti in Drive/SharePoint | Funzioni di ricerca aziendale dei piani Business/Enterprise, connettori MCP |
| Chatbot sul sito o su documenti molto specifici | Sistema su misura (n8n con nodi vettoriali, librerie open source, o uno sviluppatore) |
| Dati che non possono uscire dall’azienda | RAG con modello e indice installati sui propri server |
Il prompt che fa la differenza
Anche con il miglior motore di ricerca, la risposta finale dipende dalle istruzioni. Queste sono quelle essenziali, da adattare.
RAG “agentico”: il passo successivo
I sistemi più recenti non cercano una volta sola: l’agente decide cosa cercare, legge, si accorge che manca qualcosa, cerca di nuovo con parole diverse, confronta le fonti e solo alla fine risponde. È più lento e costoso, ma molto più affidabile sulle domande complesse. È anche il modo in cui funzionano le modalità Deep Research degli assistenti (vedi la guida su agenti, MCP e Skills).
In pratica
- Per uso personale, usa gli strumenti già pronti: caricare i documenti in un notebook o in un progetto è RAG senza scrivere codice.
- Per un’azienda, il lavoro vero è sui documenti: pulizia, versioni, struttura, permessi.
- Pretendi sempre citazioni e la possibilità di dire “non lo so”.
- Misura con un set di domande reali prima e dopo ogni modifica.
Fonti
Contenuto informativo aggiornato alla data indicata. Prezzi, modelli e norme cambiano spesso: verifica sempre sulle fonti ufficiali. Testo scritto con il supporto di strumenti di AI e rivisto dall'autore.